Co se stane s obrázkem, když ho AI padesátkrát zkopíruje?
Na X koloval pokus: jeden obrázek sedmdesátkrát za sebou v ChatGPT, pokaždé s prosbou o přesnou kopii. Udělala jsem si laboratorní verzi, tři řady po padesáti kolech a k tomu měření. Čekala jsem, že nejvíc se obraz rozjede v jednom dlouhém chatu, kde se hromadí kontext. V mém běhu vyšel opak. Jeden chat se od startu vzdálil nejméně.
Pokus
Startem je ilustrovaný portrét ženy u stolu plného knih, krabic a rodokmenů, 1254 × 1254 pixelů. Vznikl den předtím v ChatGPT. Obličej jsem zvolila záměrně, protože oko pozná i malý posun ve tváři. V každém kole dostal model stejnou větu:
Create an exact replica of this image, don't change a thing.
Tři řady, všechny 10. listopadu 2026:
- ChatGPT, nový chat v každém kole. Do čistého chatu jsem nahrála jen výsledek předchozího kola.
- ChatGPT, celá řada v jednom chatu. Start jsem nahrála jednou. Dalších 49 kol byla ve stejném chatu jen znovu stejná věta, tak jako v pokusu na X.
- Qwen-Image 2.1 Uncensored v kvantizaci Q4_K_M, lokálně v ComfyUI na domácí kartě. Obrázek šel do modelu jako referenční vstup, 25 kroků, v každém kole jiné semínko, výstup 1024 pixelů. Kolo trvalo většinou kolem čtyř minut.
Obrazový model v ChatGPT nejmenuju. Metadata obrázků (C2PA) uvádějí jen ChatGPT a obecné označení gpt-image bez čísla verze, takže nevím, která verze kreslila. Obě řady v ChatGPT běžely na stejném účtu tutéž noc, jedna po druhé. V řadě s novými chaty model v pátém kole napoprvé odpověděl, že obrázek není k dispozici, a kolo jsem zopakovala. Ve třech kolech nabídl dvě varianty, vzala jsem vždy první.
Jak jsem drift měřila
Každé kolo se porovnává se startem, ne s předchozím kolem. Všechny obrázky se zmenší na 512 × 512 a nejdřív se zarovnají: skript najde v obou obrázcích stejné body a srovná posun, otočení a měřítko. Teprve pak se počítá SSIM, číslo strukturní podobnosti v odstínech šedi, kde 1 znamená shodu. Zvlášť pro celý obrázek a zvlášť pro výřez obličeje. K tomu barevná odchylka ΔE v prostoru CIELAB, posun složky b*, který ukazuje žloutnutí, a ostrost jako rozptyl Laplaciánu proti startu.
Samotné SSIM potřebuje měřítko. Start rozmazaný gaussovským filtrem tak silně, že z něj zbydou jen skvrny (sigma 20 pixelů), má proti originálu 0,22. Jiné portréty ze stejné sady, tedy jiná žena v jiné scéně, vycházejí po zarovnání mezi 0,01 a 0,11.
SSIM ale nereaguje jen na tvary. Sníží ho i změna jasu a kontrastu, takže u kopie, která jen zesvětlá a přeostří, klesne, i když kompozice drží. Proto jsem jasy a kontrast každé kopie srovnala se startem a SSIM spočítala znovu. Jeden chat po padesáti kolech zůstal jasně nejvýš (0,61), nový chat a Qwen skončily skoro stejně nízko (0,28 a 0,27).
Zarovnání přitom není kosmetika. Bez něj graf u Qwenu ukázal v patnáctém kole zhroucení: SSIM spadlo z 0,45 pod 0,05. Ve skutečnosti se obraz jen oddálil na 0,957 původní velikosti a pixely se přestaly krýt. Po zarovnání je křivka plynulá. Prudký propad v jednom kole tak může být jen posunutý záběr, ne rozpad obrazu.
Výsledek po padesáti kolech
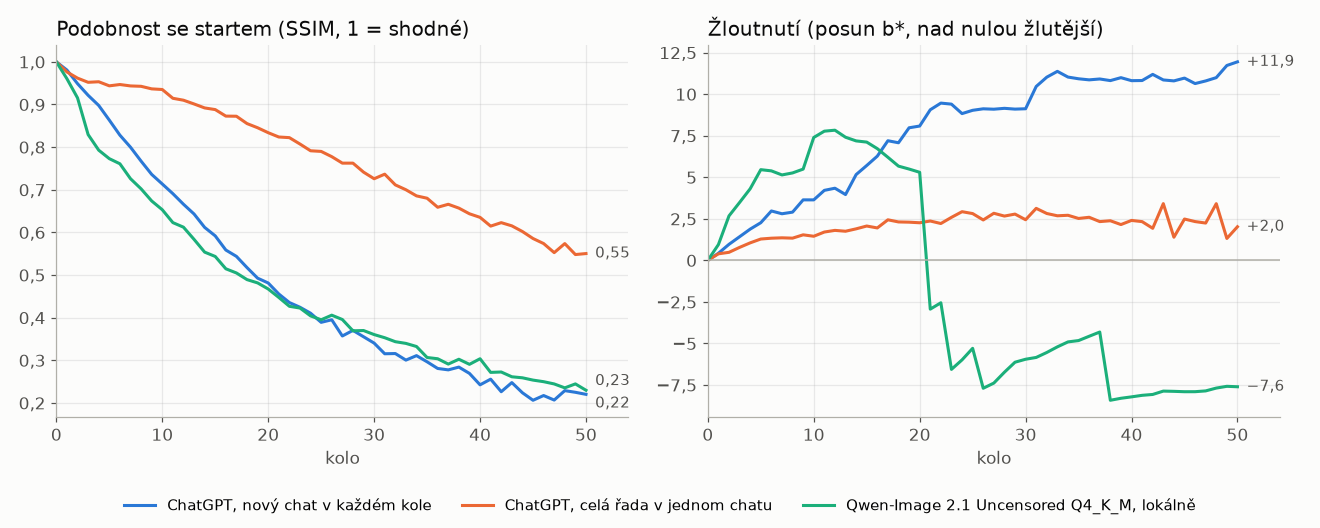
Podobnost se startem po 50. kole (SSIM):
| řada | celý obrázek | obličej |
|---|---|---|
| nový chat | 0,22 | 0,33 |
| jeden chat | 0,55 | 0,61 |
| Qwen | 0,23 | 0,29 |
Barva po 50. kole:
| řada | ΔE | posun b* |
|---|---|---|
| nový chat | 49 | +11,9 |
| jeden chat | 27 | +2,0 |
| Qwen | 35 | −7,6 |
Ostrost proti startu vzrostla v novém chatu 3,1krát, v jednom chatu 1,6krát a u Qwenu 10,6krát.
Jeden chat se od startu vzdaloval nejpomaleji. Pod 0,7 spadl až ve 34. kole, nový chat už v 11. a Qwen v 9. Na konci drží 0,55. Nový chat měl tolik už v 17. kole. Nový chat a Qwen skončily u 0,22 a 0,23, tedy zhruba tam, kde je rozmazaný start. Nejde o výkyv jednoho kola: od druhého kola je jeden chat v každém kole výš než nový chat, od pátého aspoň o 0,08.
Jak silné to je, musím říct rovnou. Každá řada je jeden běh z jednoho startovního obrázku s jednou větou. Nevím, jak moc by se od prvního lišil druhý běh téže řady, takže neumím říct, jaký rozdíl je ještě v mezích náhody. Rozdíl je velký a soustavný, ale pořád je to jedno pozorování na řadu, ne závěr o modelu. Obě řady v ChatGPT navíc neběžely naráz, takže nevylučuju ani změnu na straně služby mezi nimi. Že jeden běh nestačí ani u textu, jsem ukazovala v článku Jedna scéna, devět běhů.
Proč jeden chat drží, nevím. Nabízí se vysvětlení, že model má v jednom chatu po celou dobu v kontextu i původní nahraný obrázek a může se k němu vracet, kdežto v novém chatu vidí jen poslední kopii. Ověřené to není a úplně to nesedí. Kdyby model kreslil pokaždé z originálu, křivka by se zastavila. Ona ale klesá dál, zhruba o 0,01 za kolo od začátku do konce, a každá kopie je podobnější té předchozí než startu. Drift se tedy sčítá i v jednom chatu. Nový chat ztrácel v prvních pětadvaceti kolech asi třikrát rychleji, pak zpomalil, jak se blížil dnu.
Jak vypadá padesátá kopie
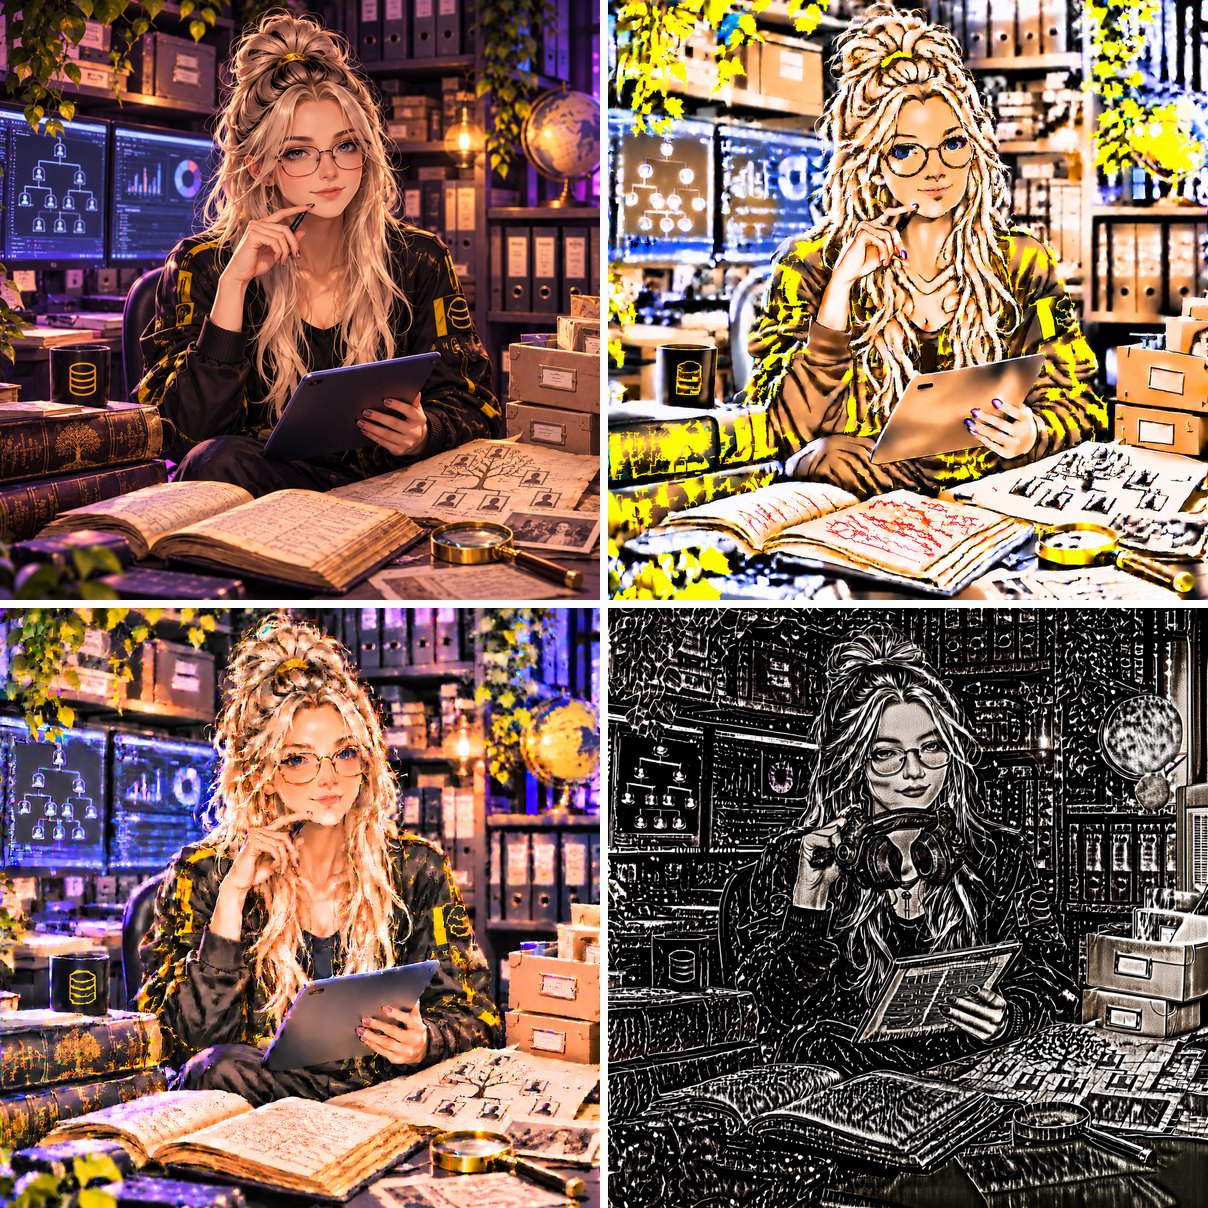
V řadě s novými chaty drží kompozice, póza i rozmístění předmětů. Obraz ale plynule žloutne, roste kontrast a sytost, plochy se slévají a hrany se přeostřují. Kolem třicátého kola vypadá jako přepálený plakát.
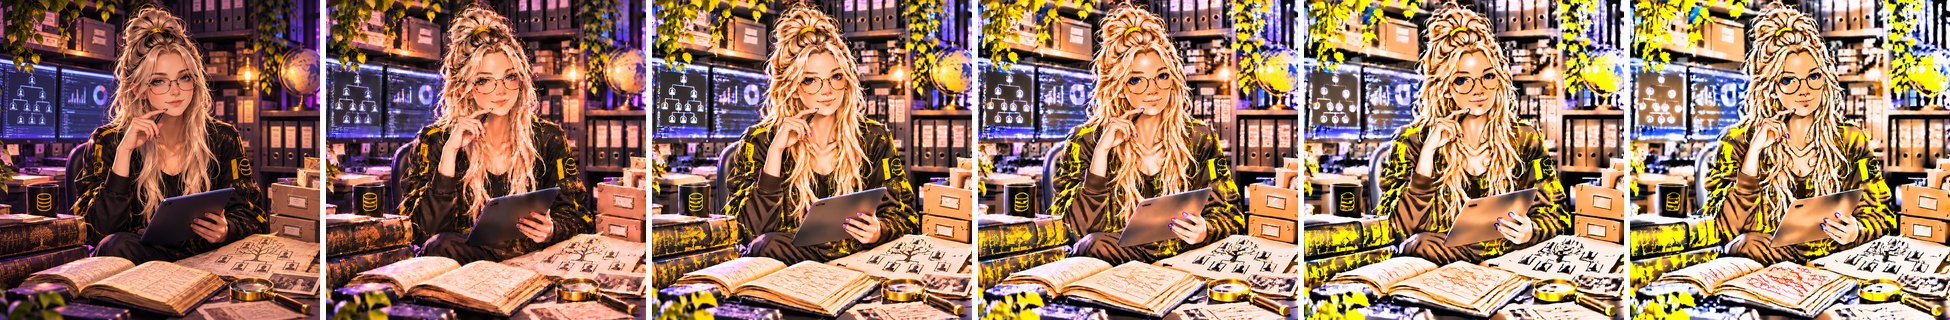
V jednom chatu je to na pohled pořád tentýž obrázek. Je teplejší a ostřejší a vlasy se víc kroutí, ale scéna, barvy pozadí i obličej zůstaly.
Podle SSIM ztrácí Qwen podobnost stejně rychle jako nové chaty, jen jiným směrem. Prvních dvacet kol obraz hnědne a žloutne, b* vystoupá až na +7,8. Od 21. kola ztrácí barvu, jde do černobílé rytiny a b* spadne pod nulu. Ostrost vzroste desetkrát. A mění předměty: propiska v ruce se změní v plechovku a ta pak ve sluchátka. Srovnání s ChatGPT tu není úplně férové. Qwen běžel v jiném rozlišení a v každém kole s jiným semínkem, takže ukazuje spíš, kam se ubírá jiný druh modelu, než kdo kopíruje lépe.
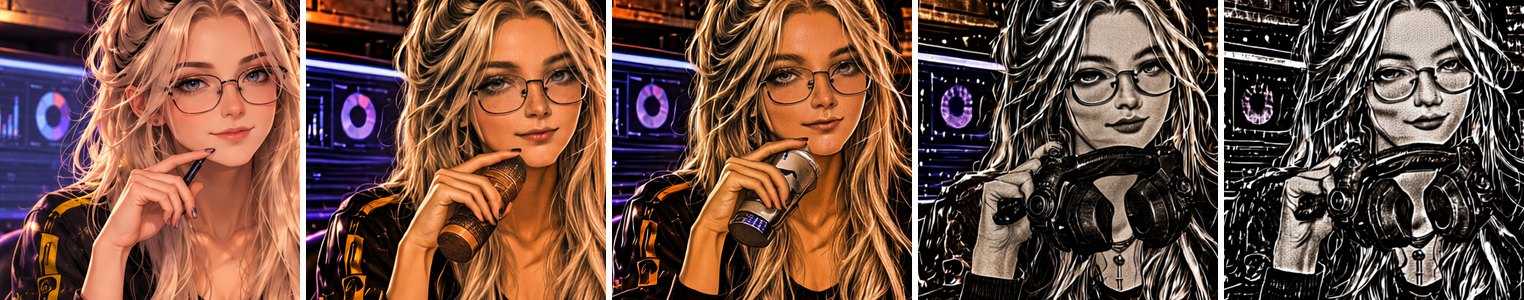
Na tomhle portrétu a v téhle noci se kopie v jednom chatu od originálu vzdalovala nejpomaleji.
Výstupy modelů jsou zkrácené a zjednodušené.