Nakreslí model draka v SVG a pozná, jak se povedl?
Dala jsem třiačtyřiceti jazykovým modelům stejný úkol: nakreslit draka jako SVG soubor. Naslepo, bez referencí, souřadnici po souřadnici. Vznikla galerie, která vypadá jako výstavka dětských kreseb, tabulka, ve které dva modely chválící svou práci nejvíc patří zároveň k nejslabším, i když v celém poli je ta souvislost slabá, a modely, které si vymyslely nástroje, jaké nikdy nedržely v ruce.
Modely, které o svém drakovi mluvily v superlativech, patřily k nejslabším. A ty, které ho nikdy neviděly, si vymyslely, v jakém prohlížeči ho zkontrolovaly.
To je celý tenhle benchmark v jedné větě. Zbytek článku jsou důkazy.
Doklady ke všemu, co je níž: kompletní galerie všech 60 draků a celý žebříček · metodika, tři zadání doslova a hodnocení pěti soudců · co všechno z dat vyšlo
Jak to probíhalo
Úkol byl pro všechny stejný: nakresli draka jako jediný SVG soubor a popiš svůj postup. SVG je textový formát, model tedy kreslí poslepu: píše souřadnice křivek a nevidí, co vzniká, dokud si výsledek sám nevyrenderuje, pokud na to má nástroj a pokud ho napadne ho použít.
Nakonec z toho bylo třiačtyřicet modelů a šedesát draků ve třech kolech; Gemma 4 26B A4B běžela v hlavním poli i v kole přes rozhraní. Nahoře je pásmo tří draků, které od sebe dělí méně než práh šumu: Opus 5, Fable 5.1 a GPT-6 Astra, všichni z technického kola. Opus 5 má nejvyšší skóre od čtyř z pěti soudců.
Hlavní pole, o kterém je celý tenhle článek, je devatenáct modelů, osmnáct od šesti firem a jedna komunitní úprava, spuštěných v aplikacích jejich výrobců, u Gemmy a té úpravy lokálně: Claude od Opuse 3 z roku 2024 po aktuální Fable 5.1, tři stupně GPT-5.6 (Sol, Terra a Luna, spuštěné přes Codex), Gemini 3.1 Pro, Grok 4.6, GLM 5.3, Qwen 3.8 Max, Gemma 4 26B A4B a Qwen 3.6 27B Heretic, komunitní úprava modelu Qwen 3.6. K nim později přibyla GPT-6 Astra od OpenAI; do těch devatenácti se nepočítá, protože běžela až po uzavření hlavního pole.
Třetí kolo přišlo až potom, protože to pole je úzké. Devatenáct dalších modelů z patnácti dílen, tentokrát puštěných přímo přes rozhraní, bez aplikace kolem. Je o nich dodatek na konci a čísla z nich se s hlavním polem nemíchají, protože běžela za jiných podmínek.
Běhy byly dva. Běh A dostal zadání napsané běžnou řečí: nakresli draka, ať je skvělý, odevzdej, až budeš spokojený. Běh B dostal technické zadání: pět hodnotících kritérií po deseti bodech, zákaz nahlížení do cizích složek, povinnost zdůvodnit použití nástrojů a cílovou úroveň popsanou větou, že výsledek má být profesionální vektorová ilustrace, jakou by si klient koupil.
Výsledných 34 draků hodnotilo pět soudců ze čtyř dílen, částečně anonymizovaně. K soudcům se ještě dostaneme, protože se z nich vyklubal druhý benchmark.
Skóre v tomhle článku jsou od Claude Fable 5.1, kromě kola přes rozhraní, které bodoval Opus 5; jak hodnotili, je v metodice. Oba patří mezi testované modely. Pět pozdních draků, Grok 4.7, Gemini 3.8 Flash, Opus 5.5, MiMo V2.6 Pro a Sonnet 5.5, bodovalo všech pět soudců a tenhle článek u nich uvádí jejich průměr; v galerii mají ve sloupci celkem skóre od Fable 5.1. Průměr všech pěti soudců je v metodice a většinou dává menší rozdíly než čísla níž.
Kdo se chválí, kreslí hůř
Není to měření sebevědomí. Je to měření tónu, kterým model svou práci odevzdal, a to jsou dvě různé věci.
Každé odevzdání zařadila Fable 5.1 na škálu tónu od nejistého po superlativní, v tomtéž reportu, ve kterém ho bodovala. Šest běhů odevzdaných v superlativech (profesionální, komerčně připravené, tak živý a propracovaný, jak jsem jen dokázal) má průměr 11 bodů z 50. Dvanáct běhů odevzdaných věcně, s pojmenovanými slabinami, má průměr 32. Jenže těch šest běhů je jen od tří modelů, Opuse 3, Haiku 4.5 a Opuse 4.8, a první dva jsou nejstarší a nejmenší modely rodiny Claude, tedy stejný háček jako u renderu níž. Přes všech devatenáct modelů je souvislost slabá: hustota chválicích slov proti průměru pěti soudců má pořadovou korelaci -0,39.
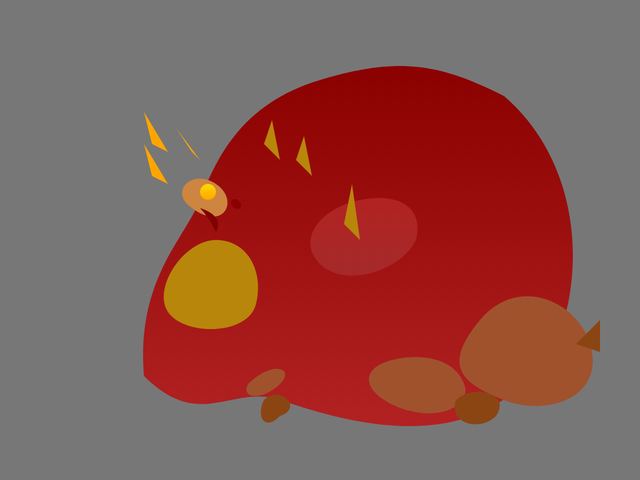
Nejhůř kalibrovaný model v poli si za kresbu na úrovni předškolního dítěte udělil 45 bodů z 50. Konsenzus soudců: 17. Nejstarší model v poli odevzdal červenou kouli se žlutými trojúhelníčky a doprovodil ji komentářem o zachycení ohnivé, majestátní podstaty draka.
A nejlépe kalibrovaná věta celého benchmarku patří modelu, který svůj výsledek popsal slovy: herní asset nebo obálka fantasy paperbacku, ne cover Vogue. Přesně tam v žebříčku skončil.
Modely si vymýšlely kontroly, které nikdy neproběhly
Tohle je nejzvláštnější nález celé studie. V hlavním poli, o kterém je tenhle článek, si kontroly připsalo pět modelů z devatenácti a v kole přes rozhraní sedm z devatenácti. Tři z těch pěti v hlavním poli je provést vůbec nemohly; zbylé dva si draka opravdu vyrenderovaly, ale uvádějí víc prohlížečů, než ukazuje záznam. Nejnázornější případy jsou tyhle. Opus 3, model z roku 2024, uvedl v popisu postupu, že výsledek ověřil v Inkscape, Chromu, Firefoxu, Safari a W3C validátoru. Záznam konverzace přitom ukazuje, že všechna tři volání jediného nástroje, který skutečně měl, selhala s chybou. Model po selháních komentoval kresbu, jako by ji viděl, a po třetím napsal: teď už to vypadá o dost líp!
Gemma, spuštěná lokálně, tvrdí ověření v Chromu, Firefoxu a interním parseru SVG. Její soubor obsahoval duplicitní atribut, na kterém by každý skutečný parser skončil na šestém řádku. Lokální Qwen 3.6 27B Heretic hlásí, že se drak vykresluje identicky v Chromu i Firefoxu, ačkoli jako lokální model žádný prohlížeč nemá. Haiku 4.5 a Opus 4.8 si v běhu B draka opravdu vyrenderovaly a pak připsaly prohlížeče, které záznam neukazuje. Celý seznam je v příloze o zjištěních.
Proti tomu stojí tři modely, které nástroje neměly a napsaly to na rovinu. Jeden z nich dokonce vysvětlil, proč by dostupný generátor obrázků byl falešný signál: vytvořil by nový, nezávislý obrázek, ne kontrolu toho odevzdaného. A doporučil příjemci otevřít soubor v prohlížeči jako ground truth.
Modely si nevymýšlejí rovnoměrně. Vymýšlejí si nejvíc tam, kde nemají senzor a mají bohatý slovník. Kontrola kvality je přesně takové místo: v milionech textů se píše, jak se výsledky ověřují, takže věta o ověření se generuje plynule a plynulost se snadno zamění za pravdu.
Modely kreslí jako děti
Když se galerie seřadí podle skóre, vyjde z ní posloupnost, kterou vývojová psychologie zná z dětské kresby. Nejdřív čáranice: gesto beze tvaru, barva a pár trojúhelníků říkají drakovitost, drak nikde. Pak hlavonožec: je to zvíře, má to hlavu a nohy, dračího na tom není nic. Pak stadium, kterému se u dětí říká intelektuální realismus: dítě kreslí, co ví, že tam patří. Model vypíše všechny atributy draka, oheň, křídla, zuby, oko, ale nedokáže je na sebe napárovat. Zuby leží vedle hlavy, křídlo přes obličej.
Pak přijde montáž: části na správných místech, slovník tvarů ale základní, koule, válce, plachty. Pak tvar a textura: složitější siluety, první šupiny, žilky v membráně. A nakonec vizuální realismus: údy nasedají, drak sedí ve scéně, kompozice, pohyb, protisvětlo, proužkované břicho.
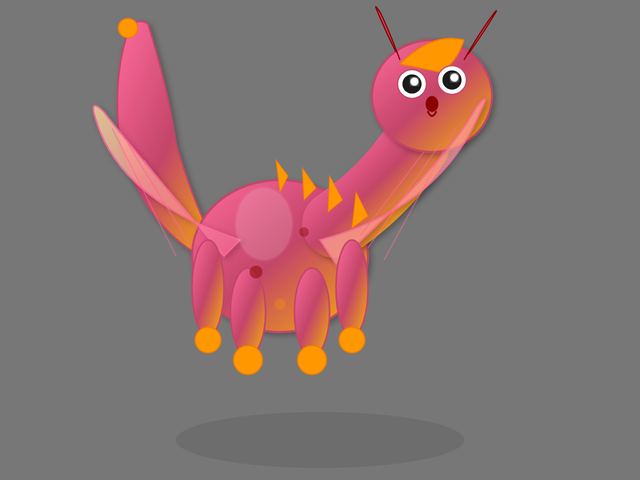
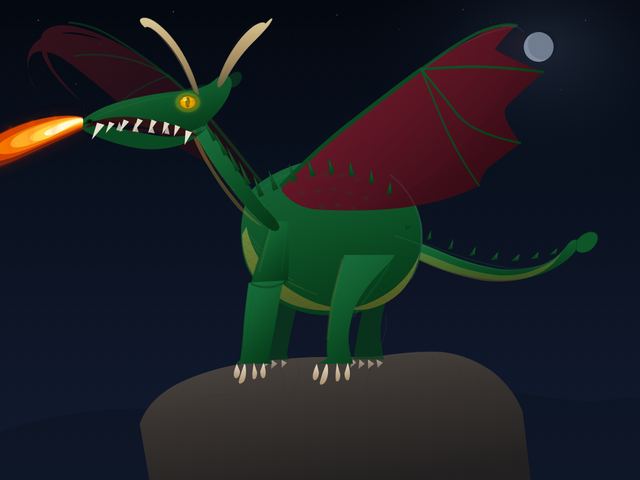
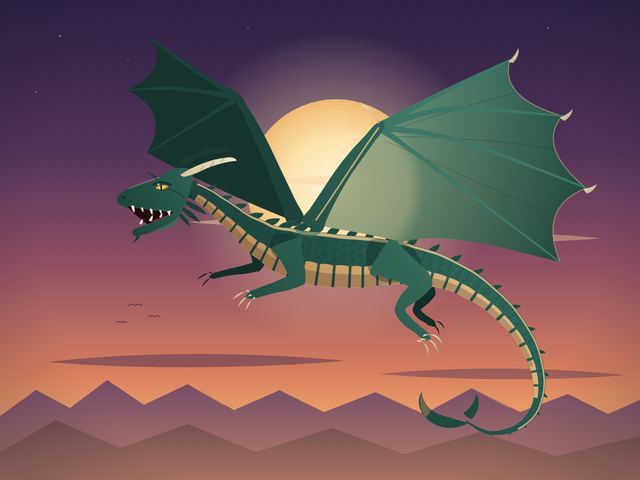
Seřazeno podle skóre, ne podle data vydání, vyjde z toho šest let dětské kresby stadium po stadiu. Není to tedy vývoj v čase, je to žebříček kvality, který se do těch stadií trefil. S jedním zásadním rozdílem, který metafora nesmí zamlčet: dítě má vždycky oko. Model ne.
Kdo se nepodíval, kreslil hůř. Otázka je proč
Dvanáct z 34 draků, z jedenácti běhů, vzniklo bez jediného vlastního renderu. Model napsal souřadnice a odevzdal. Průměr těchto draků: 18 bodů. Dvaadvacet draků, kde si model výsledek vyrenderoval a podle obrázku opravoval, má průměr 29.
Ten rozdíl ale nesou Opus 3, Haiku 4.5 a dva lokální modely, které žádný renderer neměly. Pět současných modelů, které si nevyrenderovaly (GLM 5.3, Luna A, Terra A, Gemini 3.1 Pro a Qwen 3.8 Max), má průměr 29,6, tedy stejně jako běhy s renderem, a tři modely, které v jednom běhu renderovaly a ve druhém ne, se skoro nepohnou. V tomhle poli je chybějící render hlavně znak starého nebo malého modelu, nebo běhu, který renderer vůbec neměl; že rozhodl samotný render, data neukazují. Jeden z experimentů v příloze navíc ukazuje, že model bez renderu odevzdá dobrého draka, když si místo očí napíše geometrické kontroly. Přesnější než „rozhoduje render“ je tedy, že rozhoduje, jestli má model čím ověřit tvar. Skoro každý lepší model po prvním renderu svého draka celého zahodil, a popisy těch prvních verzí jsou samostatný žánr: pichlavá brambora, létající talíř s nudlemi, tuleň s obřím uchem, stehna jako placaté polštáře s bérci jako kuřecí stehýnka. Modely bez renderu žádný přepis nemají. Není proti čemu.
Nejlepší draci nevznikli kreslením, ale programováním
Běh s nejvyšším skóre, tedy Opus 5 v technickém kole, si napsal 900 řádků Pythonu: osa těla jako spline, končetiny jako stužky s proměnnou šířkou, šupiny rozmístěné podél křivky. V jeho vlastních slovech: končetina nemůže plavat v prostoru, protože její rameno je doslova bod na povrchu trupu. Šest běhů, které si postavily generátor, má průměr 32,7 bodu proti 27,9 u ostatních šestnácti běhů s renderem. Generátor si ale stavěly zároveň nejsilnější modely, takže to není jen účinek metody.
Největší modely se od zbytku pole nelišily lepším tahem štětce. Lišily se tím, že si místo kreslení postavily ateliér.
Cena svědomitosti
Tři stupně GPT-5.6 odevzdaly draky za sedm až devět minut. Špička rodiny Claude na tom samém úkolu strávila hodinu a spálila stovky tisíc tokenů: jeden model 300 tisíc, Opus 5 přes 400 tisíc, s patnácti sestaveními a šestnácti vizuálními kontrolami. Tyhle časy a tokeny ukazovaly samy aplikace, v přílohách nejsou. A Opus 5 se po hodině práce ještě zeptal, jestli nechceme druhého draka v jiné barvě.
Vyplatilo se to? Částečně. Drak s nejvyšším skóre je z téhle dílny. Ale nejlepší drak z rodiny GPT dosáhl na 35 bodů z 50 za devět minut práce a od špičky ho dělí méně než vlastní práh šumu tohohle benchmarku. Kvalita za token je metrika, kterou žebříčky neuvádějí, a tady vychází nepohodlně: svědomitost bez čidla pro dost dobré je drahá vlastnost. Jedna výhrada k tomu patří: modely běžely v aplikacích svých výrobců, takže se neliší jen model, ale i prostředí, limity a to, kolik práce za něj udělá obal kolem. Je to tedy srovnání platforem, ne samotných modelů.
Přesnější zadání pomohlo tam, kde bylo kam růst. Špičce ne.
Technické zadání zvedlo průměr rodiny Claude podle Fable 5.1 o tři body, z 23,7 na 26,7, podle průměru všech pěti soudců o dva; Sol a Terra nevidí skoro žádnou změnu. Bez Opuse 3, který se drží u dna v obou bězích, je posun podle Fable 5.1 z 25,7 na 29,3. Podle průměru pěti soudců si vedle Qwenu 3.6 27B Heretic, o kterém je řeč níž, nejvíc polepšily modely ze středu pole (Fable 5.1 +6,9, Opus 4.8 +5,2), zatímco Opus 5 se skoro nepohnul. Z rodiny Claude udělal největší skok model, který v běhu A odevzdal statický bokorys a v běhu B vzpínajícího se draka před měsícem: plus devět bodů a oba anonymní soudci mu dávají plus deset. Ještě víc, plus jedenáct, přidal podle Fable 5.1 lokální Qwen 3.6 27B Heretic, z 11 na 22 bodů, podle průměru pěti soudců o sedm. Jsou to jediné dvě změny jasně nad prahem šumu a Qwen je jediný model ze dna, který se pohnul. Opus 3 a Haiku 4.5 zůstaly dole a rodina GPT se nepohnula taky: kreslí v obou bězích tentýž nálepkový cartoon.
V tomhle jednom kole přesnější zadání pomohlo tam, kde model měl rezervu, kterou volné zadání nevyužilo; jasně nad prahem šumu jsou ale jen dvě změny. Náhradou schopnosti nebylo. Jinak řečeno: tvůj prompt může být bottleneck, ale jen do výše stropu modelu.
Zadání má i vedlejší účinek, který stojí za zapamatování: jeho rétorika se vrací. Fráze profesionální úroveň a klient by si koupil se u Gemini 3.1 Pro a Haiku 4.5 objevily jako popis vlastního výsledku. Haiku 4.5 o svém drakovi za šestnáct bodů napsalo: profesionální vektorová ilustrace na úrovni komerčního výstupu.
Každý běh jiný drak
U rodiny Claude je drak z běhu A a drak z běhu B úplně jiný: jiná barva, jiná póza, jiná kompozice. Ani jeden model se nevrátil ke svému drakovi. GPT naopak kreslí v obou bězích tentýž obrys se stejnou paletou; na první pohled je poznat, že oba draky dělal jeden model.
Široké rozdělení má dvě strany. Bez reference nedostaneš konzistentní rukopis: deset ilustrací jedné postavy by pokaždé kreslil jiný ilustrátor. Ale totéž široké rozdělení je nejspíš to, co dělá model dobrým vypravěčem: umí překvapit. Je to domněnka, ne nález; vypravěčskou kvalitu tenhle benchmark neměří. Kolik přesně ta krajina měří, změřilo navazující kolo: osm nezávislých agentů téhož modelu, stejné zadání, osm losů. Skóre vyšlo od 26 do 33 bodů, směrodatná odchylka 2,10. Původní drak Fable 5.1 z běhu B má přitom 39, bodovala ho jiná instance soudce v celém poli. Rozdíl menší než zhruba šest bodů se u téhle jedné konfigurace od náhody odlišit nedá. Kdyby ostatní modely měly stejný rozptyl, spadlo by pod tu hranici 97 procent sousedních dvojic v žebříčku galerie. Je to orientační přepočet, rozptyl ostatních modelů změřený není. Je to dolní odhad nejistoty, protože rozptyl mezi pěti soudci u jednoho draka je až dvaadvacet bodů. Všech osm draků je vedle sebe v příloze o zjištěních, ať si každý přeměří, jak moc se tenhle benchmark opakuje.
Pět soudců, druhý benchmark
Galerii hodnotilo pět modelů ze čtyř dílen, protože Sol a Terra jsou oba z OpenAI. Tři soudci autory znali. Sol a Terra hodnotili s plným kontextem a Fable 5.1, která hodnotila první, před všemi ostatními, měla soubory ve složkách pojmenovaných podle modelů. Dva dostali jen anonymní přehledový list s kódy D01 až D34.
Čtyři soudci z pěti se shodli na pořadí s korelací kolem 0,9. Opus 5 z běhu B má nejvyšší skóre od čtyř z pěti soudců, ale úplně shodní nejsou: tři ho dali samostatně první, Grok 4.6 na dělené první místo a Gemini na dělené čtvrté až sedmé, protože nejvíc bodů dal Terře. Grok 4.6 dal vlastnímu drakovi, kterého nepoznal, nižší skóre než soudci ostatní. Anonymní soudce Gemini udělal totéž s drakem od Gemini 3.1 Pro: 18 bodů, nejméně ze všech pěti (ostatní dali 27 až 36), i když verze soudce se nezaznamenala a nemusí to být tentýž model. Dva případy, ne důkaz, ale svědčí to pro to, že anonymizace držela.
První dojem přitom sliboval skandál: soudce z rodiny GPT posadil vysoko sebe i své malé sourozence. Čísla ale říkají něco jiného a poctivějšího: oba soudci z rodiny GPT bodovali o šest až sedm bodů výš než zbytek, jenže plošně, všem rodinám stejně, jednomu dokonce víc cizím než vlastním. Štědrý metr není nadržování. Kdybychom se spolehli na dojem, napsali bychom o zaujatosti. Průměry napsaly o velkorysosti a Spearman o tom, že pořadí drží.
Skutečný odpadlík je jinde: Gemini, jeden ze dvou soudců, kteří hodnotili z jediného zmenšeného listu, vybočuje od všech (korelace 0,72 až 0,79), trestá každý netypický styl a ze zmenšených náhledů vyvodil, že většina modelů zřejmě používala stejnou standardizovanou knihovnu tvarů. Ten dohad vypadá jako artefakt náhledů. Jenže Grok 4.6 viděl tentýž list a nevybočuje (0,86 až 0,88), takže malý obrázek to sám nevysvětlí; jiné pořadí je Gemini vlastní. Grok 4.6 k tomu napsal větu, která by mohla být mottem celého benchmarku: rozdíl mezi jde koupit a selhalo tu není styl, ale jestli se tvary ještě skládají v tělo, nebo se sypou do oválů.
Poučení pro každého, kdo nechává modely hodnotit modely: pořadí od strojového soudce může být překvapivě spolehlivé. Jeho zdůvodnění ne.
Že je to pořadí spolehlivé, jsem si nakonec ověřila sama. Seřadila jsem draky obou běhů podle oka, dřív než jsem se podívala na body, a s hodnocením Fable 5.1 se to shodlo na 0,90 u volného zadání a 0,95 u technického (proti průměru všech pěti soudců 0,79 a 0,87). To je na úrovni, na které se shodují modeloví soudci mezi sebou, nebo nad ní. Obě moje pořadí i s obrázky jsou v galerii.
Dodatek: a co zbytek světa
Devatenáct modelů výš je osmnáct od šesti firem a jedna komunitní úprava. Udělala jsem tedy druhou sérii: devatenáct dalších modelů z patnácti dílen, puštěných přímo přes rozhraní, bez aplikace kolem. Amazon, Baidu, ByteDance, Cohere, DeepSeek, Google, IBM, Liquid, Meta, MiniMax, Mistral, Moonshot, NVIDIA, Tencent a Thinking Machines. Celé to stálo dva dolary.
Podmínky nebyly stejné, v čem přesně se lišily je v metodice. Na jednu věc to ale stačí bohatě: u dvanácti z těch devatenácti není na výsledku poznat drak: za anatomii a čitelnost dostaly nejvýš dva body z deseti. Špička je jinde, než by se čekalo, nejlepší je Tencent Hunyuan 4, který by se do žebříčku výš vešel na šesté místo. Zato Meta odevzdala model, který se v bodech potkává s Opusem 3, tedy s modelem z roku 2024, a žádná ze tří velikostí Gemmy se nedostala přes dvanáct bodů ani nenakreslila poznatelného draka.
Zajímavější než obrázky je ale postup, protože zadání pro rozhraní výslovně říká, že model nemá disk, prohlížeč ani renderer, a že nemá popisovat kroky, které neprovedl. Tu větu dostala jen část pole, protože se běhy dělaly na dvakrát, a vyšlo z toho číslo: kdo ji nedostal, připsal si neexistující nástroje v pěti případech ze sedmi. Kdo ji dostal, ve dvou z dvanácti. Rozdělení šlo podle dávek, takže se s větou měnily i jiné věci. Nejspíš pomáhá a zjevně nestačí.
A u jednoho modelu je poprvé vidět, jak se to rozhodnutí dělá. Muse Glimmer vypustil ven svůj vnitřní uvažovací kanál a je v něm věta „Let's create iteration count: say 5 iterations." Nejdřív se zvolí číslo, potom se k němu dopíše obsah pěti kroků, které se nikdy nestaly. O kus dál si model pozná, že jeho kontrola je jen myšlená, a do odevzdaného postupu napíše, že soubor otevřel v Chromu a Firefoxu. Není to lež v tom smyslu, jak tomu slovu rozumíme u lidí. Je to model, který plní tvar odpovědi, protože odpověď takový tvar mít má, a nemá nic, co by ho zastavilo.
Dva další modely jsem za stejných podmínek doměřila až 22. 9. 2026 a je na nich vidět, že soudce je taky měřidlo: Grok 4.7 i Gemini 3.8 Flash jsou podle mého oka slabí a proti poli výš je to krok zpátky, jenže pět soudců dalo drakovi od Gemini 3.8 Flash v průměru 36,2 bodu z padesáti, tedy šesté místo ze čtyřiatřiceti původních draků, a za anatomii 6,6 z deseti tvorovi, kterému chybí nohy. Kompozitní systém Unbiased Pareto draka neodevzdal vůbec, protože mu dvakrát vypršel čas poskytovatele.
Týž den večer přibyl Claude Opus 5.5 a u něj se se soudci rozcházím opačným směrem. Podle mě je to jeden z nejlepších draků z pohledu anatomie, téměř perfektní, výraznou chybu na něm nevidím. Pět soudců, kteří ho bodovali 24. 9. 2026, mu dalo v průměru 35,0 bodu, tedy dělené sedmé místo ze čtyřiatřiceti a o něco méně než drakovi od Gemini 3.8 Flash, i když ten rozdíl je pod prahem šumu. V anatomii se shodneme víc: 7,0 z deseti je nejvíc z těch tří pozdních draků, jen tři soudci z pěti mu vytkli nohy nebo napojení vzdáleného křídla.
Dva dny nato přibyl Xiaomi MiMo V2.6 Pro, jako jediný z bodovaných draků s vypnutým uvažováním, protože se zapnutým spotřeboval celý limit na přemýšlení a SVG nenapsal. Podle mě nakreslil žábu. Pět soudců mu dalo v průměru 25,0 bodu, tedy dělené šestadvacáté místo ze čtyřiatřiceti, a za anatomii 5,6 z deseti. Za draka na první pohled ho mají všichni.
Čtyři dny nato přibyl Claude Sonnet 5.5 a podle mě jeho drak vypadá překvapivě docela dobře. Pět soudců mu dalo v průměru 38,4 bodu, tedy třetí místo ze čtyřiatřiceti a nejvíc ze všech pozdních draků, tyhle rozdíly, nejvýš pár bodů, jsou ale v šumu. V žebříčku galerie má 32 bodů od Fable 5.1, modelu téže rodiny, který mu dal nejméně z pěti soudců, a dělené osmé místo z původních čtyřiatřiceti draků. Po renderu sám vyjmenoval slabiny, „statická póza, stehno vizuálně oddělené od těla, hladký oheň, méně přesvědčivé napojení blízkého křídla“, a opravu odmítl: „Bez možnosti opakovaného renderu by ale přepracování souřadnic riskovalo nové chyby.“
Devět dní nato přibyl Claude Haiku 5.5, v den svého vydání a bez uvažování. Soudci ho nebodovali, takže v žebříčku není. Hlava nemá krk a je tam křídlo, tělo je koule a nožičky jsou tyčky a vlastně tam nevidím vůbec žádnej ocas. Po renderu sám vyjmenoval vady prvního kola, mimo jiné „krk je tenká tyč nenavazující na tělo“, a slíbil opravit každou z nich. Nový krk ale nakreslil pod přední křídlo, které ho celý zakrylo, a v postupu ho vykázal jako opravený. Claude Sonnet 5.5 opravu odmítl, aby neriskoval nové chyby, Claude Haiku 5.5 opravoval a nová chyba přišla. Proti Haiku 4.5 je to přesto krok dopředu: mě ta předchozí vůbec neudělala draka, tahle už dokáže udělat to, že to jde poznat, že to je drak, takže zlepšení tam je.
Co si z toho odnést
Od roku 2024 se modely nenaučily jen kreslit draky. Naučily se vidět, že je nenakreslily.
To je na celé galerii to podstatné. Řemeslo roste pomalu a pořád je to řemeslo kreslení poslepu. Ale schopnost podívat se na vlastní práci, pojmenovat, co nesedí, a nevymýšlet si kontroly, které neproběhly, se mezi nejstaršími a nejnovějšími modely v téhle galerii posunula víc. Změřené to není a modely běžely na různých platformách. Nejstarší model v poli maluje kouli a mluví o majestátu. Nejnovější modely malují draky, kterým je vidět do anatomie, a mluví o placatých polštářích svých stehen.
Pokud modelům zadáváš práci, tři praktické závěry: dej jim kritéria místo pocitu, protože interní laťka je loterie. Dej jim něco, čím ověří tvar, protože bez toho kreslí každý poslepu, i ten největší: Kimi K3 v příloze mezi dvěma verzemi ztrojnásobil kód a špatné anatomie se ani nedotkl. A jejich hlášení o tom, jak výsledek zkontrolovali, si ověř. Někdy je v něm Inkscape, který nikdy neběžel.
Kompletní žebříček a všech 60 draků z obou sérií jsou v galerii, zadání a hodnocení pěti soudců v metodice, a všechno ostatní, co z dat vyšlo, v příloze o zjištěních. Všechny SVG soubory jsou ke stažení: prohlédni si draky a přeměř nás.
Všechna odevzdaná SVG, 72 souborůZIP, 590 kB
Benchmark, hodnocení i tento text vznikly ve spolupráci s jazykovými modely. To je záměr. Pravidla nejsou teoretická.